Sie haben Wochen oder Monate in das Design, die Programmierung und die Texte Ihrer neuen Unternehmenswebsite investiert. Die Seite ist feierlich online gegangen, Visitenkarten sind gedruckt – doch die erhofften Besucherströme und Neukundenanfragen bleiben völlig aus. Sie tippen Ihren Firmennamen oder Ihre wichtigste Dienstleistung bei Google ein und stellen mit Entsetzen fest: Meine Website wird bei Google überhaupt nicht gefunden! Weder auf Seite 1 noch auf Seite 5 taucht Ihre Domain auf.
Dieses Szenario ist der Albtraum jedes Unternehmers, Gründers und Marketingverantwortlichen. Doch die beruhigende Nachricht vorweg: Websites verschwinden nicht grundlos oder zufällig im digitalen Nirvana. Google folgt strengen, mathematisch präzisen Regeln. Wenn eine Webpräsenz nicht auffindbar ist, liegt dies ausnahmslos an einer konkreten technischen Barriere, einer Konfigurationspanne oder einem gravierenden Qualitätsdefizit.
In diesem umfassenden Experten-Ratgeber gehen wir den Dingen auf den Grund. Wir dekonstruieren die 12 häufigsten Ursachen, warum Websites bei Google unsichtbar bleiben, zeigen Ihnen eine erprobte 15-Minuten-Diagnose zur Fehleridentifikation und liefern praxiserprobte Sofort-Lösungen, mit denen Sie Ihre Domain schnellstmöglich in den Google-Index und auf die vorderen Ranking-Plätze führen.
1. Der größte Irrtum: Der Unterschied zwischen „Nicht indexiert“ und „Schlecht gerankt“
Bevor wir uns in die Fehlersuche stürzen, müssen wir eine fundamentale Unterscheidung treffen, die in der Praxis fast immer verwechselt wird: das Verhältnis zwischen Indexierung und Ranking.
Viele Webseitenbetreiber sagen: „Google findet mich nicht!“, meinen damit jedoch in Wahrheit zwei völlig unterschiedliche technische Zustände:
- Zustand A: Die Website ist NICHT im Google-Index: Google weiß überhaupt nicht, dass Ihre Website existiert, oder hat die Aufnahme in die Suchdatenbank verweigert bzw. abgebrochen. Die Domain ist im wahrsten Sinne des Wortes unsichtbar. Selbst wenn Sie den exakten Firmennamen oder die genaue Domainadresse eingeben, liefert Google null Ergebnisse.
- Zustand B: Die Website ist indexiert, aber SCHLECHT GERANKT: Google hat Ihre Seiten gecrawlt und in der Datenbank gespeichert. Bei der Suche nach hochgradig umkämpften Suchbegriffen (z.B. „Webdesign Berlin“ oder „Steuerberater München“) rankt Ihre Website jedoch lediglich auf Position 68 oder 140. Da 99 % aller Nutzer ausschließlich Ergebnisse auf Seite 1 anklicken, entsteht der subjektive Eindruck, die Seite sei „nicht da“.
„Der erste diagnostische Schritt besteht immer darin, zweifelsfrei festzustellen, ob ein Indexierungs-Problem oder ein Relevanz- und Autoritäts-Problem vorliegt. Nur wer das richtige Problem löst, sieht schnelle Ranking-Erfolge.“
Wie Sie diesen Unterschied innerhalb von 3 Sekunden mit dem site:-Suchbefehl nachweisen, erläutern wir detailliert im Diagnose-Kapitel.
2. Der Google Indexierungs-Trichter: Wie Suchmaschinen Websites verarbeiten
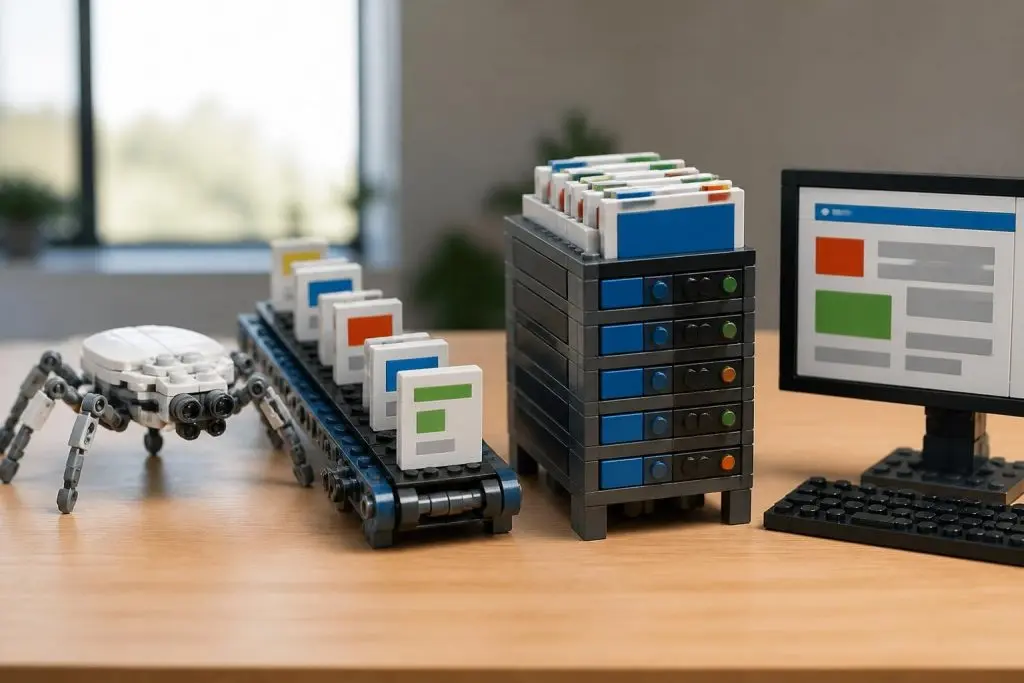
Um die Ursachen für fehlende Sichtbarkeit zu verstehen, hilft ein Blick hinter die Kulissen der Suchmaschinen-Architektur. Eine Website landet nicht automatisch im Index, sobald sie auf einem Webserver liegt. Google durchläuft einen streng mehrstufigen Prozess – den sogenannten Indexierungs-Trichter (Indexing Pipeline):
Die 5 Phasen der Google-Verarbeitung
- Entdeckung (Discovery): Google erfährt von der Existenz einer URL – entweder durch das Einreichen einer XML-Sitemap, einen internen Link von einer bekannten Seite oder einen externen Backlink.
- Crawling: Der automatisierte Web-Crawler (Googlebot) ruft den HTML-Quelltext Ihrer URL über HTTP(S) ab. Ist der Server zu langsam oder verweigert die
robots.txtden Zugriff, bricht der Prozess hier ab. - Rendern (Rendering): Der Googlebot führt JavaScript, CSS und Webfonts aus, um das visuelle und funktionale Layout der Seite wie in einem echten Google Chrome Browser aufzubauen.
- Indexierung (Indexing): Googles Algorithmen analysieren den Inhalt, prüfen auf Duplikate, bewerten die Content-Qualität und entscheiden, ob die Seite in die globale Suchdatenbank aufgenommen wird.
- Ranking & Serving: Bei einer passenden Suchanfrage ermitteln komplexe KI-Algorithmen (wie RankBrain und Helpful Content Systeme) in Millisekunden die optimale Platzierung unter tausenden Konkurrenzseiten.
Wenn Ihre Website nicht auffindbar ist, ist der Prozess in einer dieser fünf Phasen steckengeblieben. Betrachten wir nun die 12 typischen Blockaden im Detail.
3. Ursache 1: Die Website ist brandneu (Crawling-Verzögerung & Sandbox-Phase)
Haben Sie Ihre Website erst vor wenigen Tagen oder gar Stunden veröffentlicht? Dann ist die einfachste Erklärung schlichte Geduld. Das Internet umfasst hunderte Milliarden URLs, und Googles Crawler können nicht jede Sekunde das gesamte Web scannen.
Ohne aktive Signale kann es einige Tage bis zu vier Wochen dauern, bis der Googlebot eine völlig neue Domain zum ersten Mal besucht. Hinzu kommt das Phänomen der sogenannten Google Sandbox: Neue Webseiten werden von Google anfangs oft zurückhaltend behandelt. Der Algorithmus beobachtet zunächst, ob die Domain stabil erreichbar bleibt, ob Spam-Signale auftreten und wie sich erste Nutzer verhalten, bevor er solide Rankings vergibt.
Sofort-Lösung: Warten Sie nicht passiv ab. Richten Sie sofort ein Konto in der kostenlosen Google Search Console ein, verifizieren Sie den Domain-Besitz per DNS-Eintrag, hinterlegen Sie Ihre XML-Sitemap (z.B. https://ihre-domain.de/sitemap.xml) und nutzen Sie das URL-Prüftool, um manuell die Indexierung der Startseite anzustoßen.
4. Ursache 2: Versehentliches noindex-Tag im Quelltext (Der WordPress-Klassiker)
Dieser Fehler ist mit weitem Abstand die häufigste Ursache für plötzliche oder dauerhafte Unsichtbarkeit nach einem Website-Relaunch oder einer Neuerstellung. Ein einfaches HTML-Meta-Tag im Kopfbereich (<head>) teilt Suchmaschinen mit: „Nimm diese Seite unter keinen Umständen in den Suchindex auf!“
Sieht der Googlebot dieses Tag, respektiert er es bedingungslos: Die Seite wird sofort aus dem Index geworfen oder gar nicht erst aufgenommen.
Der berüchtigte WordPress-Haken
In WordPress gibt es unter Einstellungen > Lesen eine kleine Checkbox mit dem unscheinbaren Text: „Sichtbarkeit für Suchmaschinen: Suchmaschinen davon abhalten, diese Website zu indexieren“.
Entwickler aktivieren diesen Haken während der Entwurfsphase völlig zu Recht, um unfertige Seiten vor Suchmaschinen zu verbergen. Bei der Live-Schaltung wird jedoch in erschreckend vielen Fällen vergessen, diesen Haken wieder zu entfernen! Die Folge: WordPress generiert auf jeder einzelnen Unterseite das noindex-Tag, und das gesamte Projekt bleibt monatelang unbemerkt unsichtbar.
Sofort-Lösung: Prüfen Sie den Quelltext Ihrer Startseite per Rechtsklick („Seitenquelltext anzeigen“) und suchen Sie nach dem Begriff noindex. In WordPress navigieren Sie sofort zu Einstellungen > Lesen, entfernen das Häkchen und speichern die Einstellungen.
5. Ursache 3: Die robots.txt sperrt den Googlebot oder CSS/JS-Ressourcen aus
Die Textdatei robots.txt liegt im Stammverzeichnis Ihres Webservers (z.B. ihre-domain.de/robots.txt) und fungiert als Schranke für Web-Crawler. Fehlerhafte Konfigurationen können verheerende Auswirkungen haben.
Steht in Ihrer robots.txt der Befehl Disallow: /, verbieten Sie Googlebot den Zugriff auf die gesamte Website. Google darf die Seiten dann nicht einmal mehr crawlen.
Tückisch: Blockieren von CSS- und JavaScript-Verzeichnissen
Ein subtilerer, aber ebenso gravierender Fehler: Oft werden in der robots.txt Verzeichnisse wie /assets/, /css/ oder /js/ für Crawler gesperrt. Da Google Webseiten heutzutage wie ein menschlicher Browser rendert, kann der Bot die Seite ohne Stylesheets nicht visuell zusammensetzen. Er sieht ein unformatiertes Textchaos, stuft die Website als „nicht mobilfreundlich“ oder „defekt“ ein und verweigert Top-Rankings.
Sofort-Lösung: Rufen Sie Ihre robots.txt im Browser auf. Für normale Unternehmenswebsites sollte sie wie folgt aussehen:
6. Ursache 4: Fehlende, fehlerhafte oder nicht eingereichte XML-Sitemap
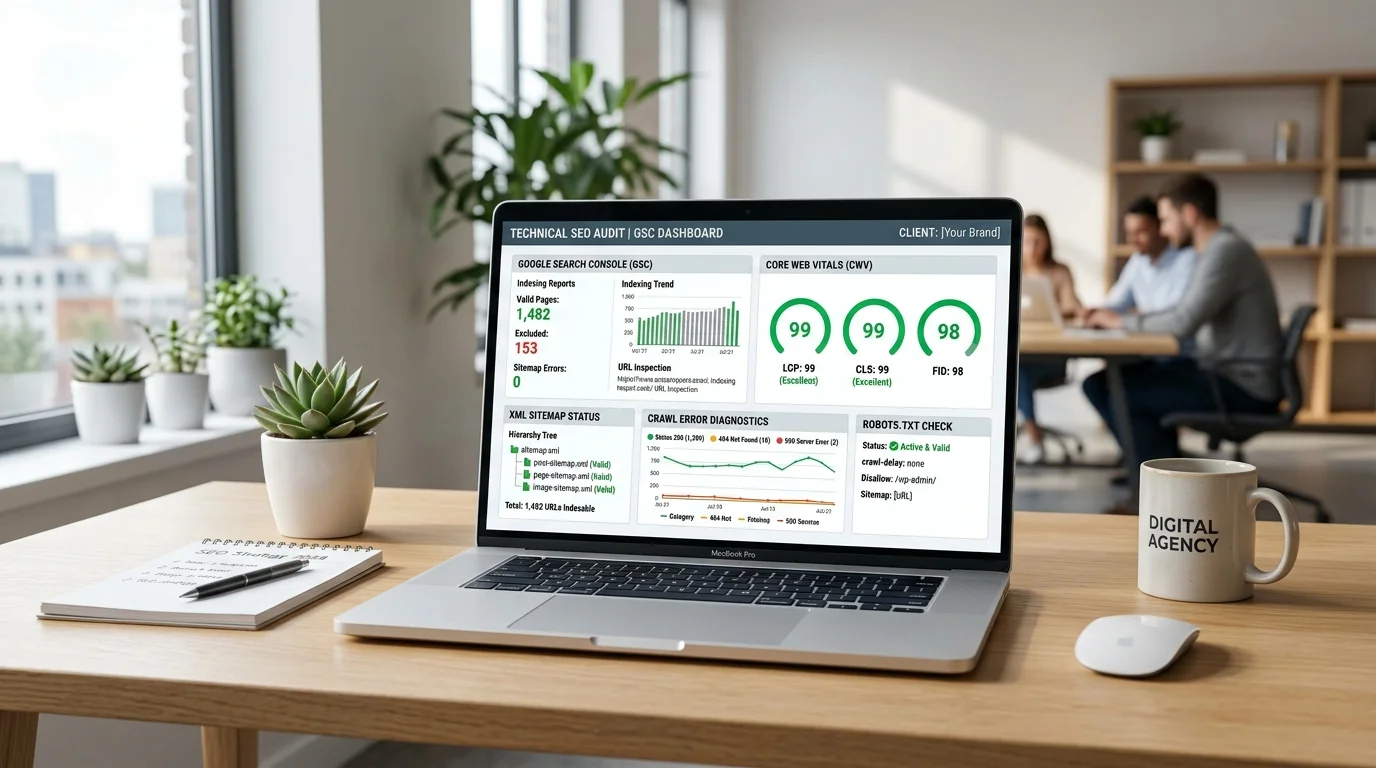
Eine XML-Sitemap ist das Inhaltsverzeichnis Ihrer Website, das speziell für Suchmaschinen aufbereitet ist. Fehlt diese Datei oder enthält sie gravierende Fehler, muss Google sich mühsam durch Hyperlinks hangeln und übersieht häufig wichtige Unterseiten.
Häufige Sitemap-Fehler in der Praxis:
- Sitemap enthält 404-Fehlerseiten oder Weiterleitungen (301): Eine Sitemap sollte ausschließlich fehlerfreie, mit Statuscode 200 antwortende Original-URLs enthalten.
- Sitemap enthält noindex-URLs: Widersprüchliche Signale (in der Sitemap einreichen, aber per noindex sperren) verwirren den Googlebot.
- Sitemap wurde nie in der Google Search Console eingereicht: Liegt die Datei nur unbemerkt auf dem Server, schöpfen Sie ihr Potenzial nicht aus.
Sofort-Lösung: Generieren Sie eine saubere Sitemap (z.B. über ein SEO-Plugin wie Rank Math oder Yoast bzw. serverseitig) und reichen Sie die URL in der Search Console unter Sitemaps ein. Prüfen Sie, ob Google den Status mit „Erfolgreich“ quittiert.
7. Ursache 5: Falsch konfigurierte Canonical-Tags & Selbstreferenzierungsfehler
Das Canonical-Tag (rel="canonical") teilt Google mit, welche URL bei duplizierten Inhalten das maßgebliche Original darstellt. Ein falsch gesetztes Canonical-Tag kann eine Unterseite vollständig aus den Suchergebnissen tilgen.
Typischer Fehlerfall: Beim Duplizieren einer Landingpage oder nach einem Relaunch verweist das Canonical-Tag auf einer Unterseite (z.B. /leistungen/webdesign/) versehentlich auf die Startseite (/) oder eine alte Test-Domain (staging.meine-seite.de). Google interpretiert dies wörtlich: „Indexiere nicht diese Unterseite, sondern das im Canonical-Tag angegebene Ziel.“ Die Unterseite wird folglich niemals separat indexiert!
Sofort-Lösung: Prüfen Sie im Quelltext jeder wichtigen Unterseite das Tag:
Jede eigenständige Unterseite sollte ein selbstreferenzierendes Canonical-Tag besitzen, das exakt auf ihre eigene, finale HTTPS-URL verweist.
8. Ursache 6: Server-Latenzen (TTFB > 2s), 500er-Fehler & Crawl-Budget-Erschöpfung
Googles Ressourcen sind nicht unbegrenzt. Für jede Website kalkuliert der Algorithmus ein sogenanntes Crawl-Budget – also die Zeitspanne und Bandbreite, die der Googlebot bereit ist, auf Ihrem Server zu verbringen.
Reagiert Ihr Webhosting extrem träge (Time to First Byte / TTFB über 1,5 bis 2 Sekunden) oder wirft der Server unter Last sporadisch HTTP-Fehler 500 oder 503 aus, zieht Google die Notbremse:
- Der Googlebot drosselt die Crawling-Frequenz drastisch, um Ihren Server nicht zum Absturz zu bringen.
- Neue Seiten bleiben wochenlang in der Warteschlange („Gefunden – zurzeit nicht indexiert“).
- Bestehende Seiten werden seltener re-indexiert und fallen bei Algorithmus-Updates zurück.
Sofort-Lösung: Investieren Sie in hochperformantes Hosting mit Serverstandort Deutschland (z.B. Vercel Edge Server, Hetzner oder IONOS Cloud), aktivieren Sie Caching, PHP 8.2+, HTTP/2 oder HTTP/3 und halten Sie Ihren TTFB unter 300 Millisekunden.
9. Ursache 7: JavaScript-Rendering-Barrieren & Client-Side Rendering (CSR)
Moderne Single-Page-Applications (SPAs) auf Basis von React, Vue oder Angular laden oft nur ein minimales HTML-Gerüst und rendern den eigentlichen Text nachträglich im Browser per JavaScript.
Obwohl Google JavaScript grundsätzlich ausführen kann, geschieht dies zeitversetzt (im sogenannten Second Wave Indexing). Kommt es dabei zu JavaScript-Fehlern, blockierenden Skripten oder API-Timeouts, sieht der Google-Renderer eine völlig weiße Seite. Was der Bot nicht sieht, kann er nicht indexieren.
Sofort-Lösung: Setzen Sie für inhaltsgetriebene Webseiten stets auf Server-Side Rendering (SSR) oder statische Generierung (SSG). Der geschriebene Text muss zwingend bereits im reinen HTML-Antwortpaket des Servers vorhanden sein.
10. Ursache 8: Weiterleitungsschleifen, Trailing-Slash-Redirects & Mixed Content
Eine saubere URL-Architektur ist das A und O für Suchmaschinen. Wenn Weiterleitungen fehlerhaft aufgesetzt sind, verliert der Crawler den Faden.
| Weiterleitungs-Fehler | Technische Ursache | Konsequenz für Google |
|---|---|---|
| Redirect Chain (Weiterleitungskette) | URL A leitet auf B weiter, B auf C, C auf D | Google bricht das Crawling nach mehreren Hops ab; PageRank verpufft |
| Redirect Loop (Endlosschleife) | URL A leitet auf URL B weiter, und B leitet zurück auf A | HTTP-Fehler; Seite kann weder gecrawlt noch indexiert werden |
| Trailing Slash Mismatch | /kontakt leitet per 308 permanent auf /kontakt/ um |
POST-Formulare brechen ab; Crawler müssen jeden Link doppelt aufrufen |
| HTTP/HTTPS Duplikate | Website ist sowohl über http:// als auch https:// erreichbar |
Duplicate Content; Google weiß nicht, welche Version maßgeblich ist |
Sofort-Lösung: Erzwingen Sie serverseitig eine 301-Weiterleitung von HTTP auf HTTPS sowie eine einheitliche Schreibweise (entweder mit oder ohne www und mit konsistentem Trailing-Slash).
11. Ursachen 9 bis 12: Thin Content, Duplicate Content, Orphan Pages & Google Penalties
Nicht jedes Problem ist technischer Natur. In den letzten Jahren hat Google die Qualitätsanforderungen massiv verschärft. Folgende inhaltliche Ursachen führen direkt zur Unsichtbarkeit:
Ursache 9: „Gecrawlt – zurzeit nicht indexiert“ (Mangelnde Qualität & Thin Content)
Wenn in der Google Search Console hunderte Seiten unter „Gecrawlt – zurzeit nicht indexiert“ auftauchen, sendet Google eine glasklare Botschaft: Wir haben die Seite gesehen, aber der Inhalt bietet der Menschheit keinen nennenswerten Mehrwert. Seiten mit nur 100 Wörtern allgemeinem Blabla, automatisierte Übersetzungstexte oder KI-Generierungen ohne Substanz fallen diesem Filter gnadenlos zum Opfer.
Ursache 10: Duplicate Content & interne Keyword-Kannibalisierung
Besitzt Ihre Website drei verschiedene Unterseiten, die alle für denselben Begriff ranken wollen (z.B. /webdesign-preise/, /kosten-website/ und /was-kostet-eine-homepage/), verwirrt dies Google. Anstatt eine starke Seite zu ranken, weiß der Algorithmus nicht, welche Seite die richtige ist – im Zweifel rankt keine von ihnen stabil.
Ursache 11: Verwaiste Seiten (Orphan Pages)
Wenn eine Seite zwar existiert, aber von keiner einzigen anderen Unterseite Ihrer Domain intern verlinkt wird, ist sie für Googlebot praktisch unauffindbar. Verlinken Sie jede wichtige Unterseite logisch in Ihrer Navigation, im Footer oder kontextuell aus thematisch verwandten Fachbeiträgen heraus.
Ursache 12: Manuelle Maßnahmen & Spam-Penalties
Haben Sie in der Vergangenheit unnatürliche Backlinks gekauft, automatisierte Spam-Texte publiziert oder Cloaking betrieben? Prüfen Sie in der Search Console unter Sicherheit & Manuelle Maßnahmen, ob ein manueller Eintrag vorliegt. Liegt eine Abstrafung vor, wird die Domain komplett aus dem Index verbannt, bis die Verstöße beseitigt und ein Reconsideration Request genehmigt wurde.
12. Die 15-Minuten-Sofort-Diagnose: Schritt-für-Schritt-Anleitung zur Ursachenfindung
Folgen Sie diesem pragmatischen Diagnose-Ablauf, um den Fehler auf Ihrer Website innerhalb einer Viertelstunde exakt zu lokalisieren:
Der 5-Schritte-Diagnose-Fahrplan
- Schritt 1: Der
site:-Test: Geben Sie bei Googlesite:ihre-domain.deein. Werden 0 Ergebnisse angezeigt? Dann liegt ein vollständiges Indexierungs-Problem vor (weiter mit Schritt 2). Werden Ergebnisse angezeigt? Dann liegt ein Ranking-/Qualitätsproblem vor (weiter mit Schritt 5). - Schritt 2: Google Search Console URL-Prüfung: Fügen Sie Ihre Startseiten-URL oben in das Prüffeld der Search Console ein. Klicken Sie auf „Live-URL testen“. Zeigt Google „URL ist für Google verfügbar“ oder meldet es „noindex erkannt“ bzw. „durch robots.txt blockiert“?
- Schritt 3: Quelltext-Audit: Öffnen Sie Ihre Website, drücken Sie
Strg + U(bzw.Cmd + Option + Uauf dem Mac) und suchen Sie nachrobotsundcanonical. Kontrollieren Sie, ob ungewolltenoindex-Attribute vorhanden sind. - Schritt 4: Server- & Header-Check: Prüfen Sie mit einem HTTP-Status-Tool oder im Terminal via cURL, ob Ihre Domain einen sauberen
Status 200 OKliefert und ob keine verstecktenX-Robots-Tag: noindex-Header vom Server mitgesendet werden:curl -I https://www.ihre-domain.de/ - Schritt 5: Indexierungsantrag stellen: Ist der Fehler behoben, klicken Sie in der Google Search Console im URL-Prüftool auf „Indexierung beantragen“. Google reiht Ihre Seite daraufhin mit hoher Priorität in die Crawling-Queue ein.
GSC-Statusmeldungen im Detail entschlüsselt: Was bedeuten die Berichte?
Im Bericht Seiten (früher Abdeckungsbericht) listet die Google Search Console verschiedene Statusmeldungen für nicht indexierte URLs auf. Die genaue Unterscheidung spart Ihnen Stunden an Rätselraten:
- „Gefunden – zurzeit nicht indexiert“: Google hat die URL entdeckt (z.B. über eine Sitemap oder einen internen Link), hat die Seite jedoch noch nicht einmal gecrawlt. Ursache hierfür ist fast immer ein überlasteter Server, ein zu knapp bemessenes Crawl-Budget oder eine extrem niedrige Domain-Autorität, weshalb Google die Seite auf die lange Bank schiebt.
- „Gecrawlt – zurzeit nicht indexiert“: Der Googlebot hat die Seite vollständig geladen und gerendert, sich aber bewusst entschieden, sie nicht in den Index aufzunehmen. Die Ursache liegt zu 90 % in mangelnder inhaltlicher Tiefe (Thin Content), duplizierten Texten oder unzureichenden E-E-A-T-Signalen. Die Lösung besteht in einer inhaltlichen Komplettüberarbeitung mit echten Alleinstellungsmerkmalen und Experten-Know-how.
- „Duplikat – vom Nutzer nicht als kanonisch festgelegt“: Google erkennt, dass der Inhalt dieser Seite bereits unter einer anderen Adresse existiert, Sie haben jedoch kein Canonical-Tag definiert. Google wählt eigenmächtig eine Haupt-URL und ignoriert die andere.
- „Duplikat – Google hat eine andere kanonische Seite als der Nutzer gewählt“: Sie haben zwar ein Canonical-Tag gesetzt, Google vertraut Ihrer Angabe jedoch nicht, weil der Inhalt auf der Zielseite zu stark abweicht oder andere Signale (wie interne Verlinkungen) dagegensprechen.
Mobile-First Indexing & Viewport-Hürden: Wenn Smartphones den Vorrang haben
Google crawlt und bewertet das Web seit geraumer Zeit ausnahmslos mit dem mobilen Smartphone-Agenten (Googlebot Smartphone). Wenn Ihre Desktop-Website zwar perfekt funktioniert, die mobile Version auf Smartphones jedoch Inhalte einklappt, Navigationselemente ausblendet oder Schriftgrößen unleserlich klein skaliert, sieht Google diese Inhalte schlichtweg nicht oder stuft die Nutzererfahrung als ungenügend ein.
Stellen Sie sicher, dass alle relevanten Überschriften, Texte, internen Links und strukturierten Daten auf mobilen Endgeräten exakt in derselben Vollständigkeit wie auf großen Desktop-Bildschirmen zur Verfügung stehen. Das Prinzip des „Responsive Webdesign mit Mobile-First-Architektur“ ist keine reine Designempfehlung mehr, sondern eine zwingende Grundvoraussetzung für jede Google-Präsenz.
In über 95 % aller Fälle lässt sich die Blockade mit dieser Systematik innerhalb kürzester Zeit identifizieren und auflösen.
13. FAQ: Häufige Fragen zur Google-Auffindbarkeit
Wie lange dauert es nach der Fehlerbehebung, bis meine Website bei Google erscheint?
Sobald Sie die technische Blockade (wie ein noindex-Tag) entfernt und in der Google Search Console die Indexierung beantragt haben, erfasst Googlebot die Änderung meist innerhalb von 24 bis 72 Stunden. Erste valide Platzierungen für Ihren Firmennamen stellen sich erfahrungsgemäß innerhalb weniger Tage ein.
Muss ich für die Google-Indexierung Geld bezahlen?
Nein, die organische Aufnahme in den Google-Index ist zu 100 % kostenlos. Fallen Sie nicht auf unseriöse Anbieter herein, die kostenpflichtige „Google-Anmeldungen“ verkaufen. Die Google Search Console ist ein kostenfreies Werkzeug von Google selbst.
Warum rankt meine Website für meinen Firmennamen, aber für keine Dienstleistungen?
Ein Ranking für den eigenen Brand-Namen erfordert minimale Relevanz, da der Begriff einzigartig ist. Für allgemeine Dienstleistungen (z.B. „Dachdecker Berlin“) konkurrieren Sie jedoch mit hunderten etablierten Mitbewerbern. Hierfür benötigen Sie tiefgründigen Content, technische Performance, solide interne Verlinkung, Backlinks und ausgeprägte E-E-A-T-Vertrauenssignale.
Hilft Google Ads (Werbung), damit meine Website organisch schneller indexiert wird?
Nein. Google trennt bezahlte Werbeanzeigen (Google Ads) und den organischen Suchindex strikt voneinander. Das Schalten von Anzeigen hat keinen direkten Einfluss auf die Schnelligkeit der organischen Indexierung oder organische Platzierungen.
Wird Ihre Website bei Google nicht gefunden oder verliert an Rankings?
Lassen Sie die Ursache von Profis analysieren. Wir durchleuchten Ihre Domain auf technische Crawling-Barrieren, fehlerhafte Tags, Server-Latenzen und Content-Schwächen – und bringen Ihre Website auf Erfolgskurs.
Kostenfreie Analyse anfordern